

使用 RL 训练无人机悬停策略#
本教程使用强化学习(RL)训练四旋翼在随机放置的目标点悬停。它遵循 Genesis World 中 RL 示例的标准三文件布局:一个把仿真包装成 gym 风格任务的环境、一个训练脚本和一个评估脚本。得到的策略足够小,可以运行在真实的 Crazyflie 上。
奖励设计参考 Champion-level drone racing using deep reinforcement learning (Nature 2023)。这是一个最小起点,而不是生产级流水线:奖励项刻意保持简单,默认批大小也没有压满 Genesis World 的并行吞吐。
这三个文件是完整代码的权威来源:
examples/drone/hover_env.py定义HoverEnv任务。examples/drone/hover_train.py配置 PPO 并运行训练。examples/drone/hover_eval.py加载检查点并推出策略。
无人机完全通过四个螺旋桨的转速来驱动。如果你还不了解 RPM 如何转化为推力和姿态,请先阅读 无人机实体;本页假定你已经理解这层映射。
任务#
每个回合会在无人机前方放置一个目标点,并奖励它飞到该点并保持位置。当无人机进入目标的 at_target_threshold(0.1 m)范围时,会重新采样一个新目标,因此单个回合会串联许多次“到达并保持”的机动。一个回合最长持续 episode_length_s(15 s),并在坠毁时提前终止。
环境必须明确任何 RL 问题都需要的三样东西:策略看到的观测、它产生的动作,以及对结果打分的奖励。
环境#
HoverEnv 是一个普通的 Python 类,而不是 gym 基类的子类。它提供 on-policy RL runner 所期望的方法:reset()、step(actions) 和 get_observations()。它的全部状态都存放在形状为 (n_envs, ...) 的批处理张量中,因此单个实例就能在 GPU 上并行驱动成千上万架无人机。
场景与无人机#
构造函数以 100 Hz 的控制频率构建场景,并添加地平面、可选的目标标记以及 Crazyflie 无人机:
self.dt = 0.01  # 100 Hz control loop
self.scene = gs.Scene(
    sim_options=gs.options.SimOptions(dt=self.dt, substeps=2),
    rigid_options=gs.options.RigidOptions(
        dt=self.dt,
        constraint_solver=gs.constraint_solver.Newton,
        enable_collision=True,
        enable_joint_limit=True,
    ),
    show_viewer=show_viewer,
)
self.scene.add_entity(gs.morphs.Plane())
self.drone = self.scene.add_entity(gs.morphs.Drone(file="urdf/drones/cf2x.urdf"))
self.scene.build(n_envs=num_envs)
build(n_envs=num_envs) 分配批处理仿真。训练时为 8192 个环境,评估时为 1 个。
动作#
策略输出四个数,每个螺旋桨一个,并裁剪到 [-1, 1]。环境把它们映射为螺旋桨 RPM,其值为悬停 RPM 的一个比例;悬停 RPM 是总推力与重力平衡时的转速:
self.actions = torch.clip(actions, -self.env_cfg["clip_actions"], self.env_cfg["clip_actions"])
# 14468 rpm is the hover point; actions scale each propeller to [0.2, 1.8] x hover
self.drone.set_propellers_rpm((1 + self.actions * 0.8) * 14468.429183500699)
self.scene.step()
学习悬停 RPM 的比例而不是绝对 RPM,可以让动作范围既小又居中,从而稳定早期训练。RPM 到力的转换见 set_propellers_rpm()。
观测#
每一步之后,环境会读取无人机状态并组装观测。每个环境的观测是一个长度为 17 的向量,每个块都被缩放到大约 [-1, 1],以免某个量主导策略输入:
self.obs_buf = torch.cat(
    [
        torch.clip(self.rel_pos * self.obs_scales["rel_pos"], -1, 1),  # target minus drone position (3,)
        self.base_quat,                                                # attitude, (w, x, y, z) (4,)
        torch.clip(self.base_lin_vel * self.obs_scales["lin_vel"], -1, 1),  # body-frame linear velocity (3,)
        torch.clip(self.base_ang_vel * self.obs_scales["ang_vel"], -1, 1),  # body-frame angular velocity (3,)
        self.last_actions,                                             # previous action (4,)
    ],
    axis=-1,
)  # shape (n_envs, 17)
线速度与角速度都在无人机的机体坐标系中表示(用基座四元数的逆进行旋转),这使策略对无人机的航向不敏感。位置误差 rel_pos 是世界坐标系下的 target - drone_position。姿态是标量在前的 (w, x, y, z) 顺序的四元数。
奖励#
环境每一步对五个项求和,每一项都乘以 dt 和来自 reward_cfg 的权重。这些权重(正为奖励,负为惩罚)位于 hover_train.py 中:
target: 奖励缩短与目标之间的距离。它基于势函数:取相对上一步的平方距离减少量,因此只要向目标靠近就会得到正分,与绝对距离无关。
smooth: 惩罚动作在相邻步之间的大幅变化,从而抑制抖动并缩小 sim-to-real 差距。
yaw: 奖励让航向保持在零附近,使用
exp(yaw_lambda * |yaw|)。angular: 惩罚机体角速度,抑制旋转。
crash: 在下面任一终止条件触发时施加的固定惩罚。
终止与重置#
当环境超时或坠毁时,它会终止并重置。坠毁条件用于防范无法恢复的状态:
横滚角或俯仰角超过阈值(180 度),
无人机在 x 或 y 方向偏离目标超过 3.0 m,或在 z 方向超过 2.0 m,
无人机下降到 0.1 m 以下(进入地面)。
reset_idx 只就地重新初始化已终止的环境,因此整个批次永远不会因为等待最慢的回合而停滞。重置会重新采样新目标并清零状态缓冲区。
训练#
训练使用 rsl-rl 中的 PPO。安装依赖:
pip install --upgrade pip
pip install tensorboard "rsl-rl-lib>=5.0.0"
hover_train.py 以性能模式在 GPU 上初始化 Genesis World,构造 HoverEnv,将其包装进 OnPolicyRunner,然后调用 learn:
gs.init(backend=gs.gpu, precision="32", logging_level="warning", seed=args.seed, performance_mode=True)
env = HoverEnv(num_envs=args.num_envs, env_cfg=env_cfg, obs_cfg=obs_cfg,
               reward_cfg=reward_cfg, command_cfg=command_cfg, show_viewer=args.vis)
runner = OnPolicyRunner(env, train_cfg, log_dir, device=gs.device)
runner.learn(num_learning_iterations=args.max_iterations, init_at_random_ep_len=True)
performance_mode=True 会把张量形状固化到编译后的内核中,从而加快步进,代价是首次构建更慢。长时间训练时开启它;交互式迭代时则保持关闭。
actor 与 critic 都是两层 MLP([128, 128],tanh),配置位于 get_train_cfg。开始训练:
python examples/drone/hover_train.py -e drone-hovering -b 8192 --max-iterations 301
-e drone-hovering: 实验名;检查点与配置写入logs/drone-hovering/。-b 8192: 并行环境数量。--max-iterations 301: PPO 迭代次数。-v: 可选,打开查看器以观看训练。
用 TensorBoard 监控训练进度:
tensorboard --logdir logs
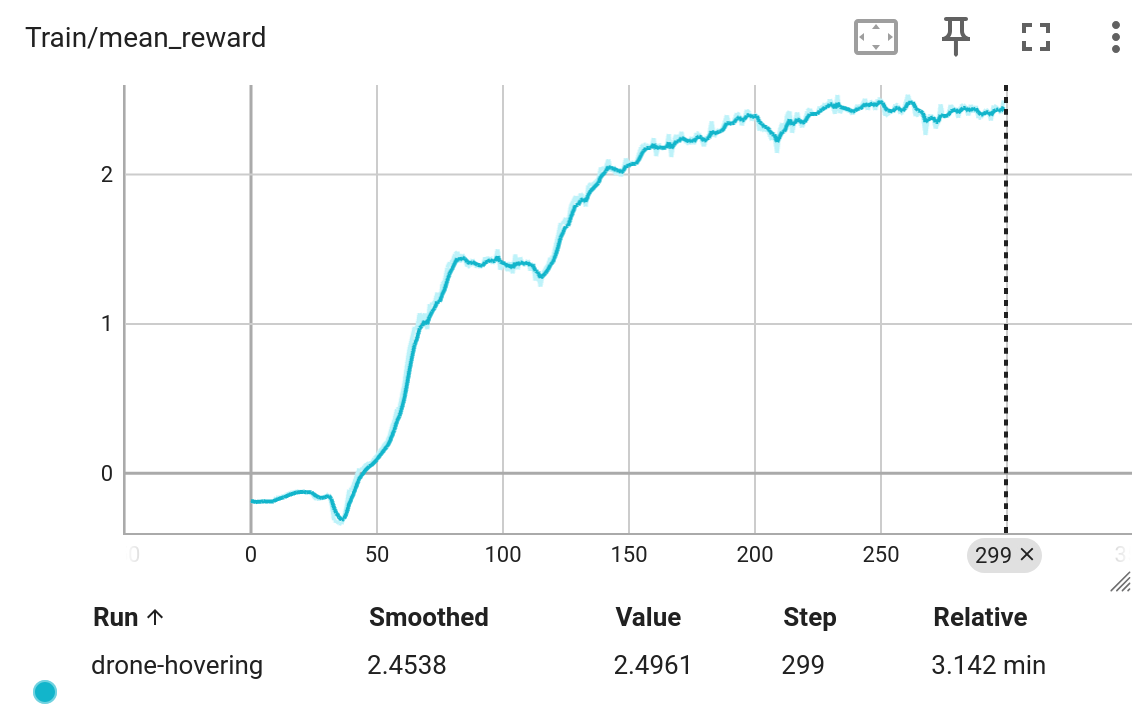
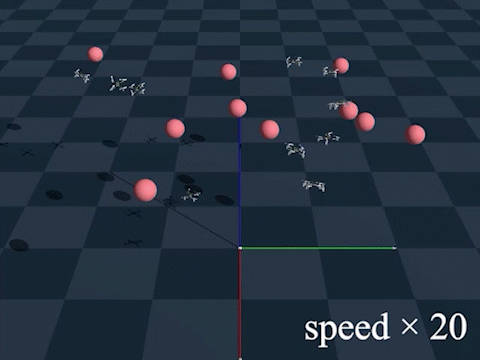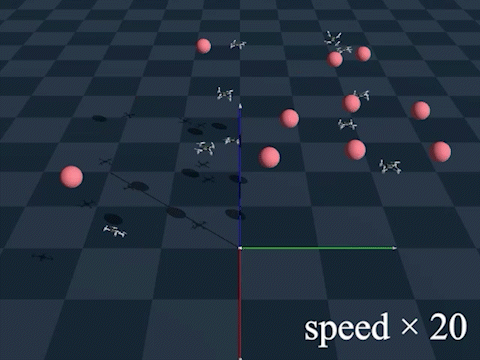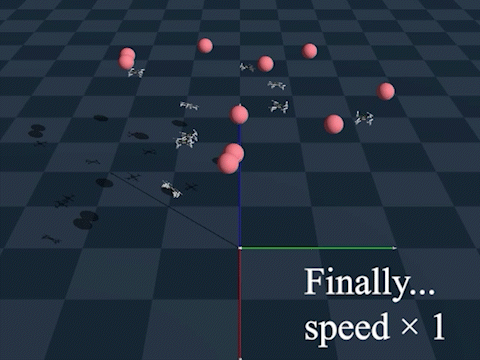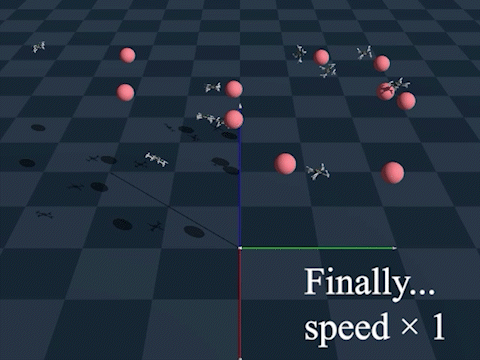
使用 -v 时,查看器会显示少量环境并行训练:
评估#
hover_eval.py 会重新加载保存的配置,以单架无人机并打开查看器重建环境,然后确定性地推出训练好的策略:
python examples/drone/hover_eval.py -e drone-hovering --ckpt 300 --record
--ckpt 300: 加载logs/drone-hovering/model_300.pt。--record: 挂载相机并把 rollout 保存到out/hover.mp4。
如果评估缓慢或不稳定,去掉 --record 以关闭渲染。
另见#
无人机实体:螺旋桨 RPM 如何产生推力、姿态与偏航。
使用 RL 训练运动策略 与 使用两阶段训练完成操作任务:同样的环境/训练/评估结构应用于其他任务。