

核心概念#
每个 Genesis World 程序都由同样少数几个对象构成,而且每个程序都在两个阶段中运行:先描述场景,再构建并步进场景。本页解释这种对象模型和计算模型,然后介绍局部索引与全局索引方案,它让一个实体能够定位到求解器数据中属于自己的那一段。阅读本页前,假定你已经看过 最小示例。
对象模型#
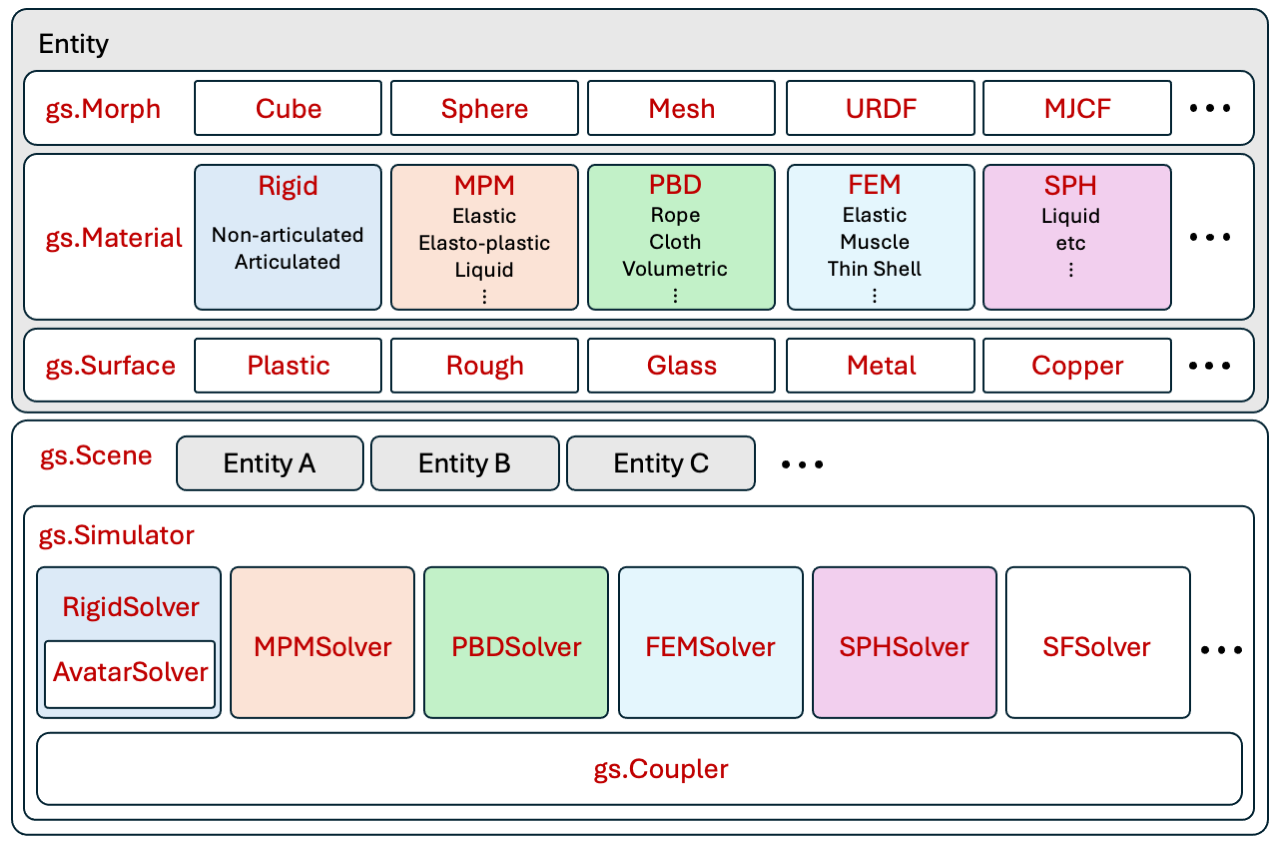
场景(scene,见 Scene API)是顶层容器。它拥有两样东西:推进物理仿真的仿真器,以及绘制你所见内容的可视化器。把所有内容添加到场景中,然后构建并步进。
实体(entity)是场景中的一个对象,例如机器人、刚体或流体。请通过它自己的方法和属性与之交互,而不是使用全局句柄。每个实体由三部分组成:
Morph: 几何形状和初始位姿,可以是基本体形状,也可以是加载的模型(见 morph API)。
材质: 物理模型。材质决定由哪个求解器仿真该实体。例如,液体既有 MPM 版本也有 SPH 版本,两者的行为不同。
表面: 视觉表面属性,例如纹理、粗糙度和反射率。
场景将所有物理计算委托给仿真器(见 Simulator API),后者协调两类组件:
求解器: 面向一类材质的物理引擎。Genesis World 提供刚体、物质点法(MPM)、有限元法(FEM)、基于位置的动力学(PBD)和光滑粒子流体动力学(SPH)等求解器。每个实体恰好属于一个求解器,由它的材质决定。
耦合器: 求解器之间的桥梁。它传递力并处理跨材质类型的相互作用,因此 MPM 流体可以推动它落到的刚体。
关于如何配置它们,请参阅 求解器与耦合。
构建与步进#
Genesis World 将仿真的描述与运行分开,二者的分界就是 scene.build():
scene.build(n_envs=0)
for i in range(1000):
    scene.step()
在 build() 之前,场景只是一份描述。添加实体会注册它们的 morph、材质和表面,但此时还不存在仿真数据。build() 是 Genesis World 布置这些数据、分配设备内存,并针对这一确切配置即时编译 GPU 内核的时刻。由于编译依赖于数据布局,必须先冻结场景:构建之后就不能再添加实体。
n_envs 控制并行度。保持为 0 时,场景运行单个环境,结果没有批次维度。当 n_envs > 0 时,Genesis World 会将场景复制到对应数量的并行环境(env)中,并且每个输入和输出都会出现一个前导批次维度。这就是文档中的形状都写成 ([n_envs,] ...) 的原因:用多个环境构建时存在 n_envs 轴,否则该轴不存在。参见 并行仿真。
每次 scene.step() 将仿真推进一个时间步 dt。要捕获或恢复某一时刻的完整仿真状态,请使用 scene.get_state()(返回 SimState)和 scene.reset(state)。
Note
新配置的首次构建会即时编译内核,因此速度较慢。Genesis World 会缓存这些内核,所以之后使用相同配置的运行可以快速启动。缓存细节参见 你好,Genesis World。
局部索引与全局索引#
单个场景中常常包含许多同类实体,而求解器将它们的数据集中存储在一个扁平数组中。理解实体如何定位到该数组中属于自己的部分,就能解答大多数关于读取和设置仿真数据的问题。
整个场景共用一个 field#
求解器将其状态保存在结构化的 field 中,也就是一个 Quadrants 数组,其中每个元素都是一个小型结构体。MPM 求解器的逐粒子渲染状态就是一个简洁的例子:
struct_particle_state_render = qd.types.struct(
    pos=gs.qd_vec3,
    vel=gs.qd_vec3,
    active=gs.qd_bool,
)

self.particles_render = struct_particle_state_render.field(
    shape=(self._n_particles, self._B),  # every particle in the scene, across all envs
    needs_grad=False,
    layout=qd.Layout.SOA,
)
该 field 的长度为 n_particles,即场景中所有 MPM 实体的粒子总数。Genesis World 连续存储这些实体,并记住每个实体的起始位置,而不是给每个元素标记实体 id——那样会在每个访问该 field 的内核上消耗内存和带宽。
同一份数据的两种视图#
这种偏移方案为同一个数组提供了两种索引方案:
局部索引: 定位一个实体内部的数据,从零开始计数。例如机器人的第一个关节,或流体中的第 30 个粒子。
全局索引: 直接定位求解器的 field,跨越场景中的每个实体。
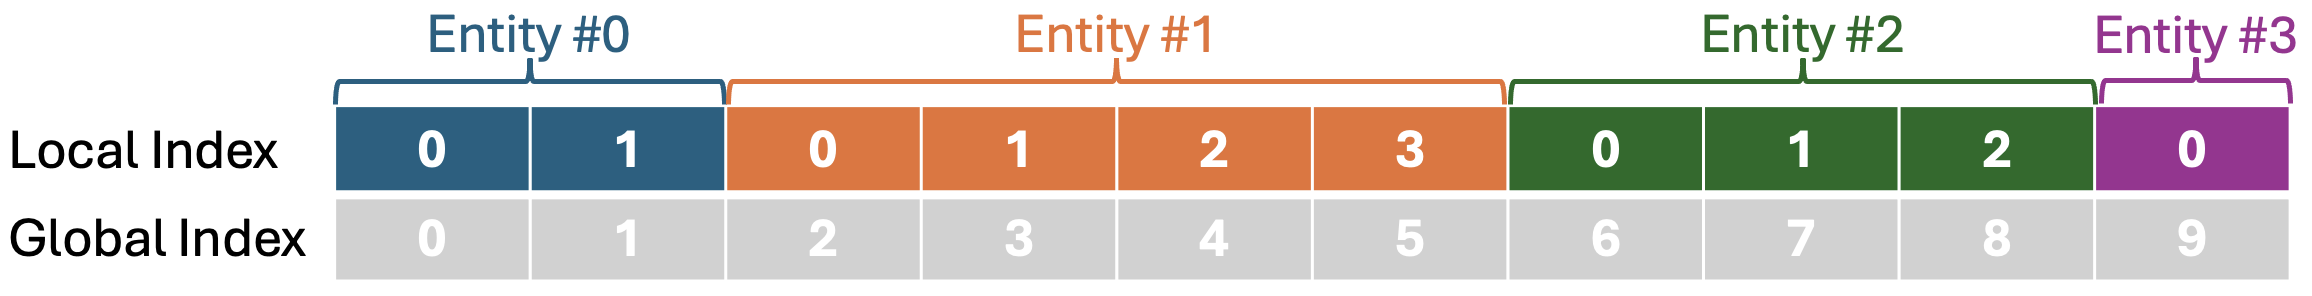
局部索引是你使用的接口;全局索引是底层的布局。实体 API 会通过加上实体的起始偏移,为你完成两者之间的转换,因此在正常使用中你无需处理原始的全局索引。
对于粒子实体,set_velocity(vel) 接收仅按该实体粒子形状组织的速度,并将它们写入共享 field,写入时按实体的 particle_start 偏移(这是它在 field 中的第一个索引;particle_end 等于该值加上粒子数)。
对于刚体实体,名为 *_idx_local 的参数都是局部索引。因此,读取第三个自由度(dof)需要传入局部索引:
pos = rigid_entity.get_dofs_position(dofs_idx_local=[2]) # shape ([n_envs,] 1)
在内部,它会先映射为全局索引 2 + rigid_entity.dof_start,然后才访问求解器的 field。相关的实体组件系统(ECS)模式很适合作为延伸阅读。
直接访问 field#
优先使用实体 API,例如 get_dofs_position。它们会应用偏移、返回批次优先的张量,并且能在内部实现变化时保持正确。只有在某个值尚无 API 暴露时才直接访问 field,并应预期这类代码更慢、更脆弱。
每个实体都通过 entity.solver 暴露其求解器,每个物理量都位于该求解器中已知的位置(例如自由度位置位于 dofs_state.pos),并且 field 使用全局索引。因此,像下面这样受支持的调用:
tgt = entity.get_dofs_position() # shape ([n_envs,] entity.n_dofs)
读取的值,与用 entity.dof_start:entity.dof_end 切片求解器全局 field 所得到的结果相同。关于物理量到求解器 field 的完整映射,请参阅 命名与变量。
另请参阅#
你好,Genesis World:最小化的构建与步进程序。
并行仿真:一次运行多个环境。
求解器与耦合:配置求解器和耦合器。
命名与变量:物理量到求解器 field 的映射。