

使用两阶段训练完成操作任务#
本示例训练 Franka 机械臂在随机放置的盒子上方到达可抓取位姿,然后交给脚本化的闭合与抬升流程。它采用 sim-to-real 操作中常见的一套两阶段配方:先在特权真实状态(ground-truth state)上训练一个教师策略,再把它蒸馏成一个只看到立体相机图像的学生策略。教师因为拥有完美信息而学得很快;学生则继承这一行为,同时只依赖真实机器人实际能产生的输入。
完整代码位于 examples/manipulation/,分为四个文件:
grasp_env.py: 环境,两个阶段共用。grasp_train.py: 配置以及两个阶段的训练入口。behavior_cloning.py: 学生策略网络及其蒸馏循环。grasp_eval.py: 推出任一策略。
本页解释设计;代码以这些文件为准。
为什么分两个阶段#
抓取策略最终必须基于相机图像运行,因为真实机器人无法直接读出物体的位姿。用强化学习从零训练视觉策略很慢:网络的大部分样本都花在学会“看”上,之后才能学会“做”。
这里的配方把这两个问题分开。
阶段 1,教师: 在特权状态上做强化学习,即直接从仿真器读取精确的末端执行器与物体位姿。有了完美观测,一个小型 MLP 就能在数千个并行环境中快速学会该任务。
阶段 2,学生: 一个卷积网络,接收立体 RGB 图像,并通过行为克隆模仿教师。它从不查询 RL 奖励,只是从像素复现教师的动作。
可部署的产物是视觉学生策略。
环境#
两个阶段共用 GraspEnv。它采用与 运动控制 和 无人机悬停 示例相同的 gym 风格结构:reset() 返回观测,step(actions) 返回 (observations, rewards, dones, infos)。
场景中包含一个地平面、一台带平行夹爪的 7 自由度 Franka Panda 机械臂,以及一个红色盒子。每次重置都会随机化盒子的状态:位置从机器人前方的一片区域内采样,偏航角也会被扰动,因此策略无法记住单一目标。
# random object state, sampled per environment on reset
random_x = torch.rand(self.num_envs, device=self.device) * 0.4 + 0.2  # meters
random_y = (torch.rand(self.num_envs, device=self.device) - 0.5) * 0.5
random_yaw = (torch.rand(self.num_envs, device=self.device) * 2 * math.pi - math.pi) * 0.25  # radians
特权观测#
教师的观测是一个 14 维的真实状态向量,以键 "policy" 返回:
obs_components = [
    finger_pos - obj_pos,  # gripper-to-object offset, shape ([n_envs,] 3)
    finger_quat,           # gripper orientation (w, x, y, z)
    obj_pos,               # object position, shape ([n_envs,] 3)
    obj_quat,              # object orientation (w, x, y, z)
]
四元数遵循 Genesis World 约定,采用标量在前的 (w, x, y, z) 顺序。该状态仅在仿真中可用,因此只保留给教师。
视觉观测#
学生则读取放置在工作空间左右两侧的两个 RGB 相机。get_stereo_rgb_images() 会沿通道轴堆叠它们,并归一化到 [0, 1]:
rgb = env.get_stereo_rgb_images(normalize=True) # shape (n_envs, 6, H, W); 3 left + 3 right, H = W = 64
在安装了可选 Madrona 批处理渲染器 的 CUDA 后端上,相机会在一次渲染中处理所有环境。否则环境会回退到内置光栅化器,因此即使没有 Madrona,示例也能运行:
if _ENABLE_MADRONA and gs.backend == gs.cuda:
    CameraOptions = BatchRendererCameraOptions
    cam_kwargs = dict(use_rasterizer=True)
else:
    CameraOptions = RasterizerCameraOptions
    cam_kwargs = {}
相机通过 scene.add_sensor(...) 添加;传感器 API 见 相机传感器,批处理环境的运行方式见 并行仿真。
动作与控制#
动作是一个 6 维向量:末端执行器的位置增量与姿态增量,各自乘以 action_scales(每步 0.05)。环境用阻尼最小二乘逆运动学把该笛卡尔增量转换为关节目标,并通过位置控制驱动机械臂:
q_pos = self._dls_ik(action)          # Cartesian delta -> joint targets
q_pos[:, self._fingers_dof] = self._gripper_open_dof
self._robot_entity.control_dofs_position(position=q_pos)
在学习到的 rollout 全程,夹爪保持张开。策略的任务是把夹爪对齐到可抓取位姿,而不是闭合夹爪。真正的抓取与抬升是脚本化序列(grasp_and_lift_demo),在策略完成机械臂定位后运行。
奖励#
学习由单个奖励项驱动:关键点对齐。参考关键点分别附着在夹爪和物体上,当两组关键点重合时奖励增大:
reward_scales = {
    "keypoints": 1.0,
}
def _reward_keypoints(self) -> torch.Tensor:
    ...
    dist = torch.norm(finger_pos_keypoints - object_pos_keypoints, p=2, dim=-1).sum(-1)
    return torch.exp(-dist)  # 1.0 when perfectly aligned, decaying to 0
对齐关键点会同时约束位置与姿态,因此不需要额外的稠密塑形项。
阶段 1:用 RL 训练教师#
阶段 1 使用 rsl_rl 库中的近端策略优化(PPO)训练教师,这与运动控制和悬停示例使用的是同一个训练器。actor 与 critic 都是读取 "policy" 观测组的小型 MLP。
安装依赖:
pip install tensorboard "rsl-rl-lib>=5.0.0"
开始训练:
python examples/manipulation/grasp_train.py --stage=rl
默认会运行 2048 个并行环境(-b/--num-envs)、训练 300 次迭代。环境越多,PPO 每次更新获得的样本越多;上限由 GPU 显存决定。如何进一步提高批大小,见 高效环境设计。
用 TensorBoard 监控训练进度:
tensorboard --logdir=logs
成功的运行会产生一条上升并在 1.0 附近趋于平稳的奖励曲线,这正是关键点奖励在完美对齐时逼近的值:
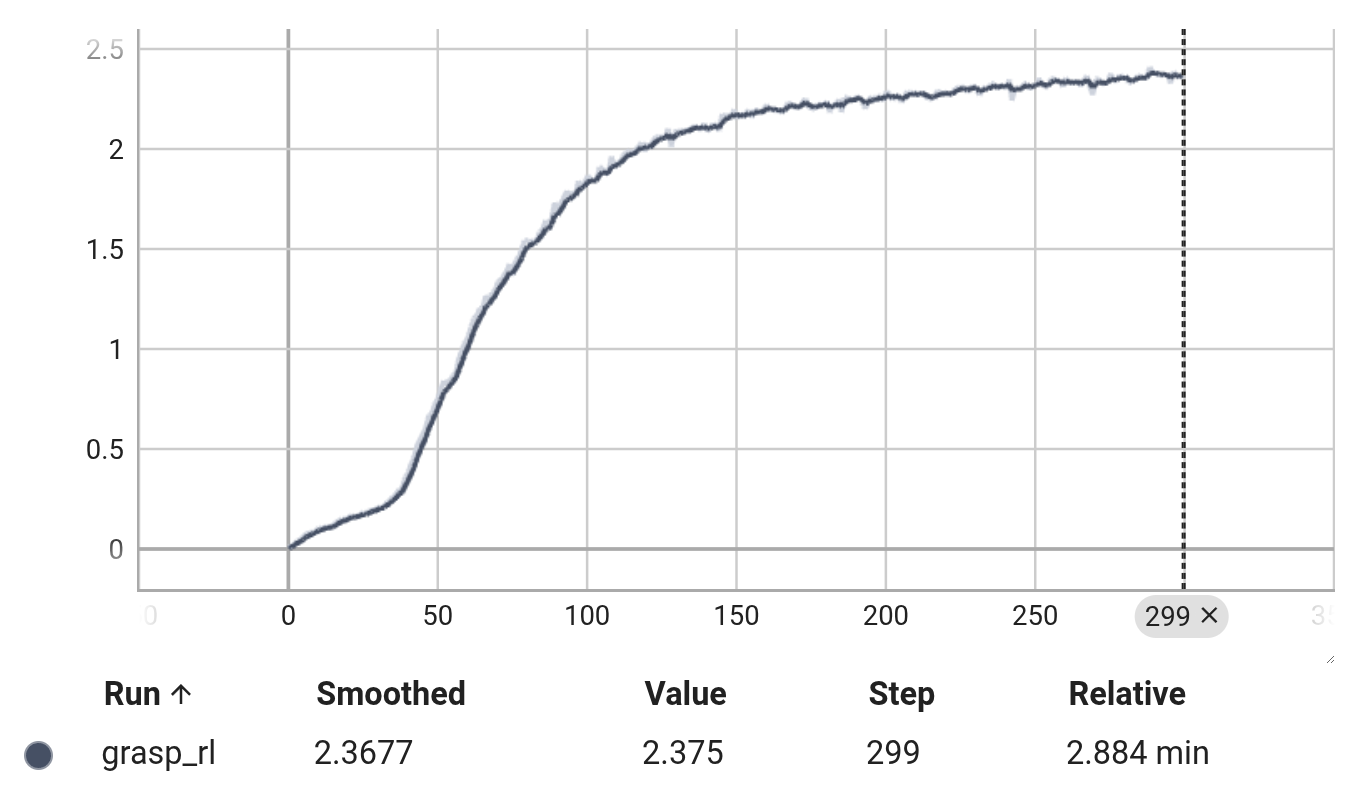
检查点以 model_<iter>.pt 写入 logs/grasp_rl/。阶段 2 会自动加载最新的一个。
阶段 2:蒸馏为视觉学生#
阶段 2 训练视觉学生,其定义位于 behavior_cloning.py。该网络是一个 Policy 模块,包含三部分:
共享立体编码器: 一个 CNN 作用于左右图像,其特征由线性层融合。两个视图共享权重可以让编码器保持小巧。
动作头: 一个 MLP,从融合后的视觉特征与 7 维末端执行器位姿拼接后预测 6 自由度动作。
位姿头: 一个辅助 MLP,回归物体的位姿(
xyz加四元数)。它是训练辅助手段,促使编码器表示物体几何;部署时并不使用。
训练会最小化动作模仿损失加上辅助位姿损失:
action_loss = F.mse_loss(pred_action, batch["actions"])   # match the teacher
pose_loss = pose_left_loss + pose_right_loss              # position MSE + quaternion distance
total_loss = action_loss + pose_loss
数据在线来自教师,并采用 DAgger 风格的协变量偏移防护:每一步学生提出一个动作,只有该动作与教师的动作足够接近时,环境才会执行它,否则回退到教师的动作。这样既能让 rollout 停留在教师擅长的状态附近,又能让学生接触到自己的错误:
# DAgger: trust the student near the teacher, defer to the teacher otherwise
action_diff = torch.norm(student_action - teacher_action, dim=-1)
condition = (action_diff < 1.0).unsqueeze(-1).expand_as(student_action)
action = torch.where(condition, student_action, teacher_action)
在教师训练完成之后运行:
python examples/manipulation/grasp_train.py --stage=bc
该阶段会从 logs/grasp_rl/ 加载最新的教师检查点,因此要先训练教师。它只使用 10 个环境,因为现在的瓶颈是渲染而不是仿真。损失与检查点(checkpoint_<iter>.pt)会写入 logs/grasp_bc/。
评估#
用 grasp_eval.py 推出任一策略。评估会打开查看器,并在策略完成机械臂定位后运行脚本化的抓取与抬升,让你看到完整的拾取过程。
教师策略,读取特权状态:
python examples/manipulation/grasp_eval.py --stage=rl
学生策略,仅读取立体相机。传入 --record 可将渲染视图以视频形式保存到 logs/grasp_bc/:
python examples/manipulation/grasp_eval.py --stage=bc --record
Note
评估脚本复用训练期间 pickle 保存的配置(logs/<exp>_<stage>/cfgs.pkl),因此环境与策略训练时一致。它还会在评估时把盒子改为自由(非固定)刚体,让机械臂能够真正把它抬起来。
另见#
使用 RL 训练运动策略 与 使用 RL 训练无人机悬停策略:环境结构相同的单阶段 PPO 示例。
相机传感器:立体观测背后的渲染 API。
控制你的机器人:环境使用的逆运动学与位置控制原语。