

使用 RL 训练运动策略#
本教程为 Unitree Go2 四足机器人训练一个行走策略,并在查看器中推出该策略。这是一条刻意保持最小的流水线:一个 gym 风格的环境、来自外部 RL 库的 PPO,以及一段简短的评估循环。奖励项经过简化,以便策略能快速学会行走,因此请把它当作起点,而不是可用于生产的运动控制方案。
构成该示例的三个脚本是完整代码的权威来源:
go2_env.py:环境,包括场景、控制、观测、奖励与重置。go2_train.py:超参数与训练入口。go2_eval.py:加载检查点并运行策略。
该设计借鉴了 Legged Gym 的结构。
前置条件#
训练使用外部库 rsl-rl 中的 PPO,并将日志写入 TensorBoard。请把它们与 Genesis World 一起安装:
pip install tensorboard "rsl-rl-lib>=5.0.0"
脚本要求 rsl-rl-lib>=5.0.0;如果存在更旧的版本,启动时会抛出 ImportError,因为该示例依赖这个版本引入的观测组与 TensorDict 约定。
环境#
Go2Env 是一个标准的 RL 环境:它拥有一个 Genesis World 场景,该场景建立在许多 环境 之上,并对外提供 reset() 和 step(actions)。训练会在单张 GPU 上并行运行成千上万个机器人副本,因此每个缓冲区都带有前置的 n_envs 维度,步进逻辑也始终在设备上以向量化方式执行。
构造函数会为所有环境只构建一次场景:
self.scene = gs.Scene(
    sim_options=gs.options.SimOptions(
        dt=self.dt,  # 0.02 s -> 50 Hz control, matching the real robot
        substeps=2,
    ),
    rigid_options=gs.options.RigidOptions(
        enable_self_collision=False,
        max_collision_pairs=20,  # a walking Go2 rarely exceeds this; a low cap saves memory
    ),
    ...
)
self.scene.build(n_envs=num_envs)
n_envs 在构建时设置,而不是在构造时设置,下游所有内容都按它来确定尺寸。
控制#
关节位置空间中的 PD 控制器驱动机器人。环境按名称定位 12 个腿部关节,并在构建完成后一次性设置它们的增益:
self.robot.set_dofs_kp([self.env_cfg["kp"]] * self.num_actions, self.motors_dof_idx)  # kp = 20.0
self.robot.set_dofs_kv([self.env_cfg["kd"]] * self.num_actions, self.motors_dof_idx)  # kd = 0.5
策略既不输出力矩,也不输出绝对关节角。它输出的是围绕机器人默认站立姿态的残差,step 会将该残差缩放后叠加到默认姿态上,形成位置目标:
target_dof_pos = exec_actions * self.env_cfg["action_scale"] + self.default_dof_pos  # action_scale = 0.25, rad
self.robot.control_dofs_position(target_dof_pos[:, self.actions_dof_idx], slice(6, 18))
围绕默认姿态进行驱动,可以让早期探索保持在稳定站姿附近,因此策略能在几百次迭代内找到一种步态。环境还会把上一步的动作送入控制器(simulate_action_latency),以复现真实 Go2 表现出的一步(约 20 ms)驱动延迟,从而缩小 sim-to-real 差距。
观测#
step 在 scene.step() 之后读回机器人状态,把基座线速度与角速度转换到机器人自身坐标系,然后组装策略输入:
self.obs_buf = torch.concatenate(
    (
        self.base_ang_vel * self.obs_scales["ang_vel"],           # 3, base-frame angular velocity (rad/s)
        self.projected_gravity,                                   # 3, gravity direction in base frame
        self.commands * self.commands_scale,                      # 3, target lin_vel_x, lin_vel_y, ang_vel_yaw
        (self.dof_pos - self.default_dof_pos) * self.obs_scales["dof_pos"],  # 12, joint-position residual (rad)
        self.dof_vel * self.obs_scales["dof_vel"],                # 12, joint velocity (rad/s)
        self.actions,                                             # 12, previous action
    ),
    dim=-1,
)
观测是一个 45 维向量,形状为 (n_envs, 45)。每一项都乘以固定比例,使各分量在进入网络之前处于可比的量级。get_observations 会把缓冲区包装成键为 "policy" 的 TensorDict,这正是 rsl-rl 期望的格式:
def get_observations(self):
    return TensorDict({"policy": self.obs_buf}, batch_size=[self.num_envs])
命令就是任务本身:每个环境的前向速度、侧向速度与偏航角速度目标。环境每隔 resampling_time_s 以及在重置时,会在配置范围内随机重新采样命令,因此单个策略学会的是跟随一个速度命令分布,而不是某一种固定步态。
奖励#
总奖励是六个项的加权和,每一项都是环境上的一个方法。其中两项奖励任务完成情况,另外四项对运动进行正则化:
奖励项 |
作用 |
比例 |
|---|---|---|
|
跟随命令的 xy 速度 |
|
|
跟随命令的偏航角速度 |
|
|
惩罚竖直方向的弹跳 |
|
|
让基座保持在目标高度附近 |
|
|
惩罚动作的突变 |
|
|
保持接近默认关节姿态 |
|
两个跟踪项使用误差平方的指数函数,这样既能奖励接近目标,又不会过度加权近乎完美的跟踪:
def _reward_tracking_lin_vel(self):
    # Tracking of linear velocity commands (xy axes)
    lin_vel_error = torch.sum(torch.square(self.commands[:, :2] - self.base_lin_vel[:, :2]), dim=1)
    return torch.exp(-lin_vel_error / self.reward_cfg["tracking_sigma"])
每个原始项都会乘以其比例和 dt,因此这些权重可以理解为每秒的速率,并且与控制频率无关。所有奖励配置都位于 go2_train.py 的 get_cfgs 中;要调整行为,修改这些比例即可,而不必改动环境。
重置#
当某个环境的回合达到 episode_length_s、基座横滚角或俯仰角超过 10 度(机器人已摔倒),或者物理求解器报告数值错误时,step 会将该环境标记为需要重置。它会在原地把这些环境重置到初始姿态,不打断其他环境,并为每个环境重新抽取一条命令。
训练#
环境定义好后,go2_train.py 会把它交给 rsl-rl 的 OnPolicyRunner,由后者训练 PPO 策略。actor 与 critic 都是三层 MLP([512, 256, 128],ELU);完整的超参数集位于 get_train_cfg。脚本会在 GPU 上以 performance_mode=True 初始化 Genesis World,该选项会把静态张量形状固化到编译后的内核中,从而加快步进,代价是场景变化时需要重新编译——对于长时间训练来说,这是值得的权衡:
gs.init(backend=gs.gpu, precision="32", logging_level="warning", seed=args.seed, performance_mode=True)
在仓库根目录下开始训练:
python examples/locomotion/go2_train.py
默认情况下,它会在实验名 go2-walking 下并行运行 4096 个环境、训练 101 次迭代,并把检查点和 cfgs.pkl(实际使用的配置)保存到 logs/go2-walking/。可以用 -b/--num-envs、--max-iterations 或 -e/--exp-name 覆盖其中任意一项。
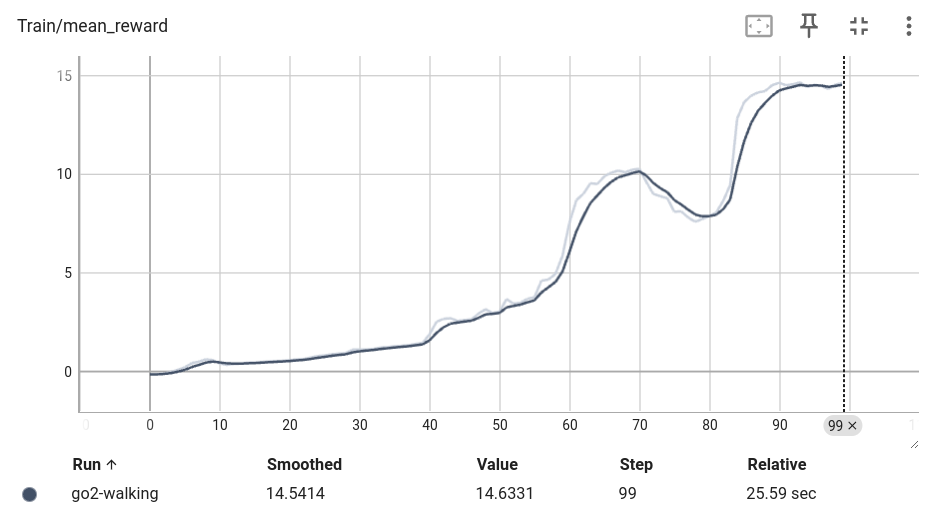
用 TensorBoard 监控训练进度:
tensorboard --logdir logs
评估#
go2_eval.py 会重新加载保存的配置,以单个环境并打开查看器重建 Go2Env,恢复检查点,然后循环推进策略:
runner.load(os.path.join(log_dir, f"model_{args.ckpt}.pt"))
policy = runner.get_inference_policy(device=gs.device)

obs_dict = env.reset()
with torch.no_grad():
    while True:
        actions = policy(obs_dict)
        obs_dict, rews, dones, infos = env.step(actions)
评估会在 CPU 上初始化 Genesis World(gs.init(backend=gs.cpu)),对于打开查看器的单个环境来说已经足够。运行时需指定实验名和要加载的检查点:
python examples/locomotion/go2_eval.py -e go2-walking --ckpt 100
训练好的策略是一个标准的关节位置控制器,可以部署到真实的 Go2 上。
变体#
go2_backflip.py 复用同一套 Go2Env 机制来实现动态后空翻。它通过继承环境加入基于相位的观测,并运行预先训练好的策略;单次与双次后空翻的检查点随附在 examples/locomotion/backflip/ 中:
python examples/locomotion/go2_backflip.py -e single
python examples/locomotion/go2_backflip.py -e double
另见#
最佳实践:让步进循环留在 GPU 上,并在各环境之间随机化物理参数。
使用 RL 训练无人机悬停策略:同样的流水线应用于四旋翼。
使用两阶段训练完成操作任务:将强化学习与模仿学习结合的两阶段流水线。